


ДНР, Донецк


СДЕЛАЙТЕ СВОИ УРОКИ ЕЩЁ ЭФФЕКТИВНЕЕ, А ЖИЗНЬ СВОБОДНЕЕ
Благодаря готовым учебным материалам для работы в классе и дистанционно
Скидки до 50 % на комплекты
только до
Готовые ключевые этапы урока всегда будут у вас под рукой
Организационный момент
Проверка знаний
Объяснение материала
Закрепление изученного
Итоги урока

Был в сети 06.05.2026 10:24

Волков Владимир Александрович
Преподаватель технических и технологических дисциплин
 23 768
 1 469

Местоположение
Специализация
Прикладной модуль 1. Потоки данных.
Категория:
Информатика
15.04.2025 13:29

Просмотр содержимого документа
«Прикладной модуль 1. Потоки данных.»
Группа Т(О), ТГ(О), С(О)–24-02, 2025 год
Занятие по рабочей программе №21
Дисциплина: БД.08 «Информатика»
Прикладной модуль 1. Основы аналитики и визуализации данных.
Тема: Потоки данных.
- Цель занятия:
Дидактическая:
сформулировать представление студентов и получить практические навыки работы с Моделями данных;
выяснить назначение применения ПО во время выполнения работы;
систематизировать и объяснить сущность работы с потоками данных;
определение основ аналитики и визуализации данных;
углубить и закрепить знания по дисциплине «Информатика».
Воспитательная:
развивать коммуникативные способности;
развивать аналитические способности;
развивать творческий подход к процессу обучения.
воспитывать самостоятельность, дисциплинированность;
стимулировать студентов к изучению дисциплины;
побуждать к формированию активной жизненной позиции;
прививать уважение и любовь к будущей профессии.
Вид занятия: лекция.
Тип занятия: обобщение и систематизация знаний.
Форма проведения занятия: репродуктивная и эвристическая беседа.
Междисциплинарные связи:
Обеспечивающие Математика, Охрана труда, Безопасность жизнедеятельности.
Обеспечиваемые
Информационные технологии в профессиональной деятельности, и др.
Методическое обеспечение: опорный конспект.
Литература:
Филимонова, Е. В. Информатика и информационные технологии в профессиональной деятельности: учебник / Е. В. Филимонова. – Москва: Юстиция, 2019. – 213 с. – (Среднее профессиональное образование). - ISBN 978-5-4365-2703-1.
Зимин, В. П. Информатика. Лабораторный практикум в 2 ч. Часть 1 : учебное пособие для среднего профессионального образования / В. П. Зимин. — 2-е изд., испр. и доп. — Москва : Издательство Юрайт, 2023. — 126 с. — (Профессиональное образование). — ISBN 978-5-534-11851-3. — Текст : электронный // Образовательная платформа Юрайт [сайт]. — URL: https://urait.ru/bcode/514893
3. Блог компании OTUSАнализ и проектирование систем*
ХОД ЗАНЯТИЯ
Ознакомление с темой, целью и планом занятия.
Тема: Потоки данных.
ПЛАН
Организация потоков данных.
Виды потоков данных.
Реактивность.
Когда следует использовать потоки данных.
Архитектурные решения для обработки потоковых данных.
Изложение и изучение нового материала.
ЛИТЕРАТУРА: [5], стр.
1. Организация потоков данных
Данные приходят в программу, а вот как с ними работать дальше...
Программы — это преобразователи данных. Мы даём программе задачу: вводим начальные данные и ожидаем получить какой-то результат после их преобразования.
Сложные программы делят исходную задачу на задачи поменьше. За разные подзадачи отвечают разные части программы — функции, классы, модули.
Чтобы программа выполнила исходную задачу целиком, её части должны работать сообща. Они общаются друг с другом с помощью промежуточных результатов работы — тоже данных.
То, как одна часть программы получает и передаёт данные другим, называется потоком данных (data flow) и может определить архитектурное устройство всей системы.
2. Виды потоков данных
Скопировать ссылку "Виды потоков данных"
В целом, потоки данных могут быть организованы огромным количеством способов, но чаще всего на практике во фронтенде встречаются два:
однонаправленный (one-way).
двунаправленный (two-way).
2.1. Однонаправленный поток
Скопировать ссылку "Однонаправленный поток"
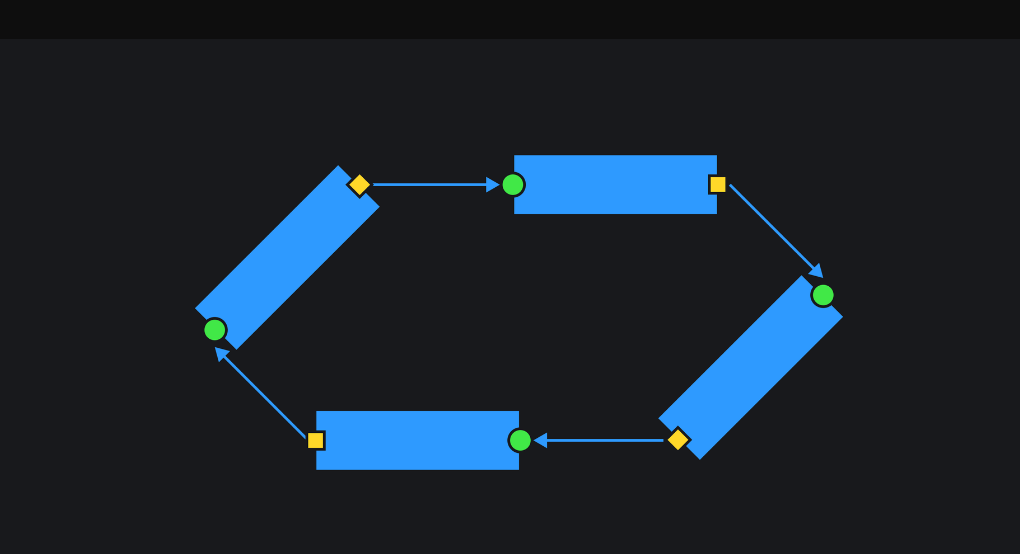
В однонаправленном потоке данных каждая часть программы от другой части может либо получить данные, либо передать. Направление такого потока не меняется.
Однонаправленный поток можно схематично представить, как водопровод, а модуль - как часть трубы:

В таком потоке данные «текут» от одного модуля к другому, а выходные данные предыдущего становятся входными следующего:
2.2. Flux / Redux
Скопировать ссылку "Flux / Redux"
Самый известный пример архитектуры с однонаправленным потоком данных — это Flux и, как его реализация, Redux.
Во Flux приложение состоит из 3 главных компонентов:
хранилище данных или стор, store;
диспетчер, dispatcher;
представление или вью, view.
Задача стора похожа на задачу модели из MVC — он хранит в себе данные. Изменение данных в сторе влечёт за собой изменение представления, то есть перерисовку пользовательского интерфейса.
Отметим, что стор сам по себе не перерисовывает интерфейс, это не его задача. Обычно на изменение данных в сторе реагирует UI-фреймворк, например, React.
Задача представления — показать данные в понятном для пользователя виде, нарисовать пользовательский интерфейс.
Когда пользователи совершают какие-то действия, например, нажимают на кнопки, представление вызывает экшен (action) — объект-команду, который говорит, что произошло.
Иногда во Flux выделяют 4-й компонент — создатель экшенов (action creator). Он освобождает представление от необходимости знать, как именно нужно создавать объекты-экшены.
Экшен попадает в диспетчер, он распространяет этот экшен всем модулями, которые знают, как обработать его. (В Redux такие модули называются редьюсеры, reducers.) Эти модули преобразовывают данные в хранилище. Обновление данных влечёт перерисовку представления, и цикл замыкается.

Такой поток данных похож на классический MVC.
2.3. Двунаправленный поток
Скопировать ссылку "Двунаправленный поток"
Данные в двунаправленном потоке могут передаваться между частями программы в обе стороны.
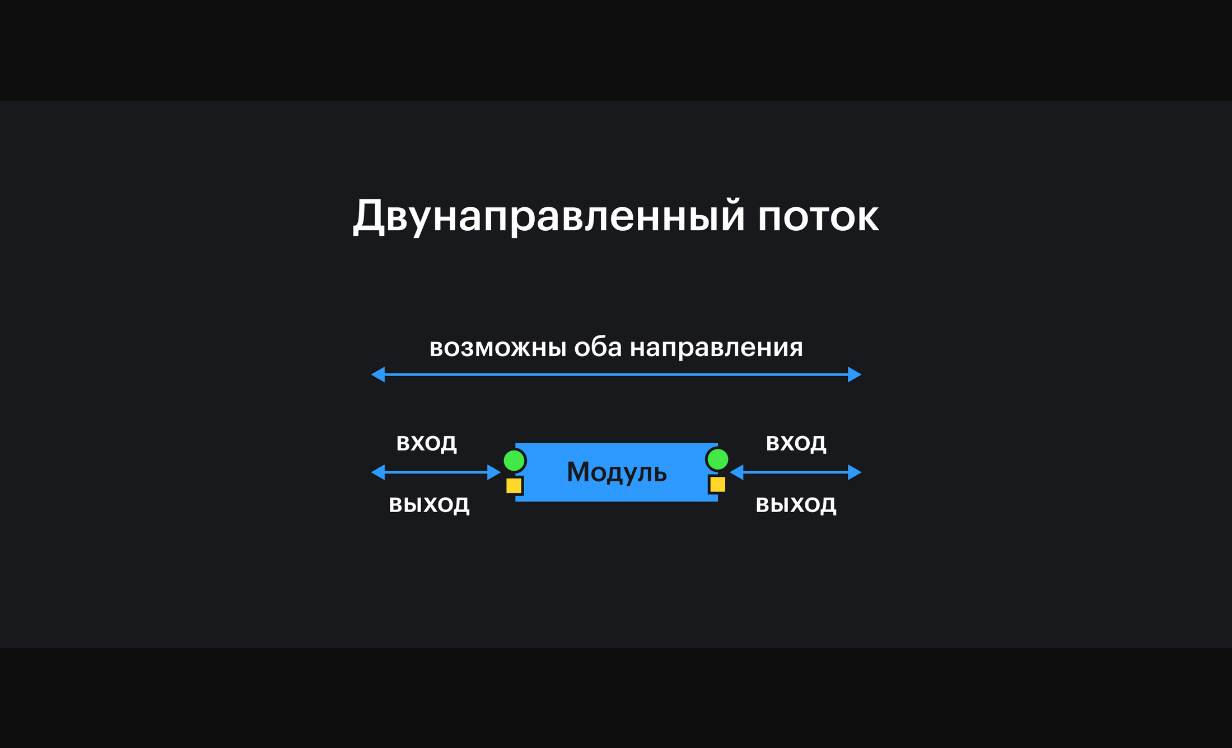
Чаще всего это используется для связывания модели и представления, чтобы обновление, например, текста в поле ввода сразу обновило данные в модели — это называется двунаправленным связыванием данных (two-way data binding).
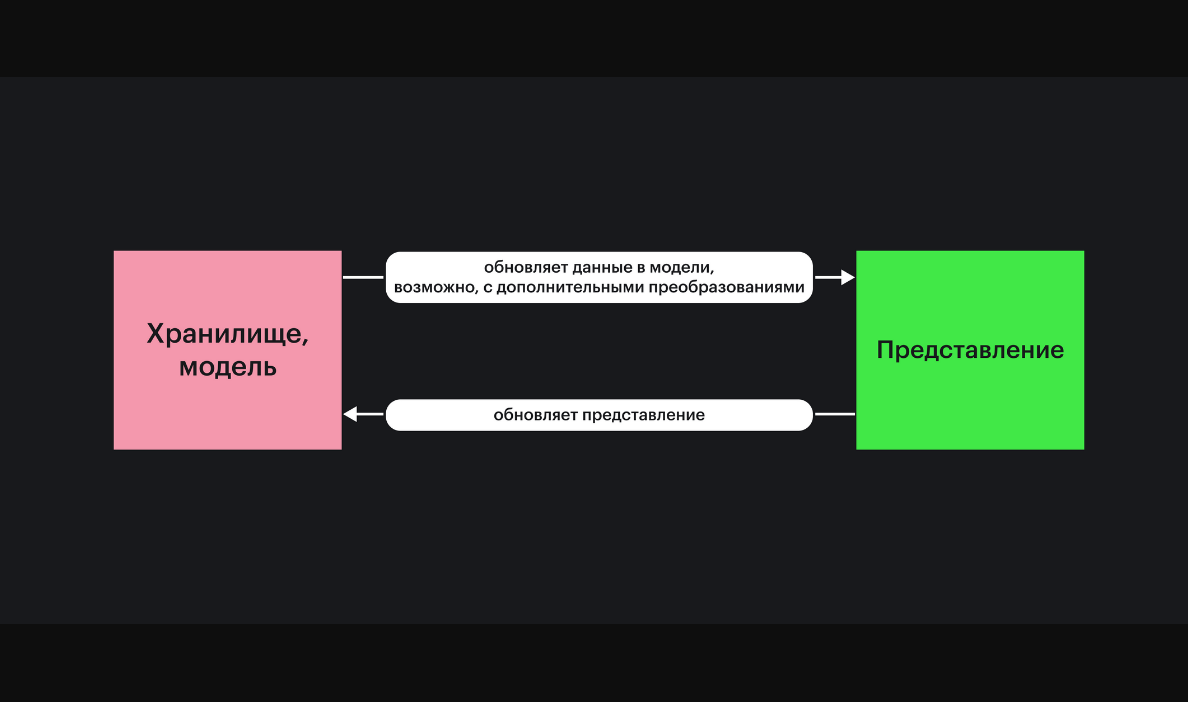
У такого «среза углов» есть и плюсы, и минусы. Из плюсов:
Меньше кода, потому что не надо писать экшен и обработчик для него.
Работает как магия, если Фреймворк делает всё автоматически за разработчиков.
Из минусов:
Труднее отлаживать, когда двойное связывание используется для чего-то сложнее, чем обновление текста в поле ввода.
Это работает как магия, если Фреймворк делает всё автоматически.
3. Реактивность
Скопировать ссылку "Реактивность"
Фреймворки, которые используют двунаправленное связывание, часто реактивные - то есть применяют изменения мгновенно не только к UI, но и к вычисляемым данным.
Представьте, что мы используем Excel. Запишем в двух ячейках численные значения, а в следующей - функцию подсчёта их суммы:
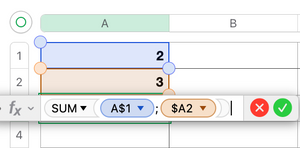
В третьей ячейке будет посчитанное значение:
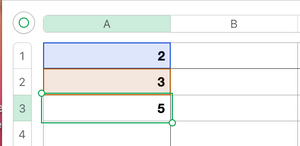
Если мы теперь изменим значение первой ячейки, значение суммы пересчитается автоматически.

Это автоматическое изменение значения в третьей ячейке - и есть реактивность. Кажется, что это ничем не отличается от простого двойного связывания, но разница есть.
Что выбрать зависит от задачи.
Нет строгих рекомендаций к выбору способа организации потоков данных. Можно учитывать, насколько будет удобно писать код, и отлаживать его.
Например, в больших или сложных приложениях или больших командах хочется меньше «магии», чтобы чётко понимать, что и при каких условиях происходит - однонаправленный поток может это обеспечить.
В небольших приложениях двунаправленный поток может сэкономить много времени, потому что заменяет собой однотипный код, который бы пришлось писать в случае с однонаправленным потоком.
4. Когда следует использовать потоки данных
Так как объем данных продолжает расти, поэтому проблема переупорядочения этих данных в хорошо сформированную, актуальную информацию. Мы хотим, чтобы данные, готовые для аналитики, заполняли визуальные элементы, отчеты и панели мониторинга, чтобы мы могли быстро превратить объемы данных в полезные аналитические сведения. С помощью самостоятельной подготовки данных для больших данных в Power BI можно перейти от данных к аналитике Power BI с помощью нескольких действий.
Совет: Можете попробовать поток данных 2-го поколения в Фабрике данных в Microsoft Fabric - решение для аналитики для предприятий. Microsoft Fabric охватывает все, от перемещения данных до обработки и анализа данных в режиме реального времени, бизнес-аналитики и отчетности.
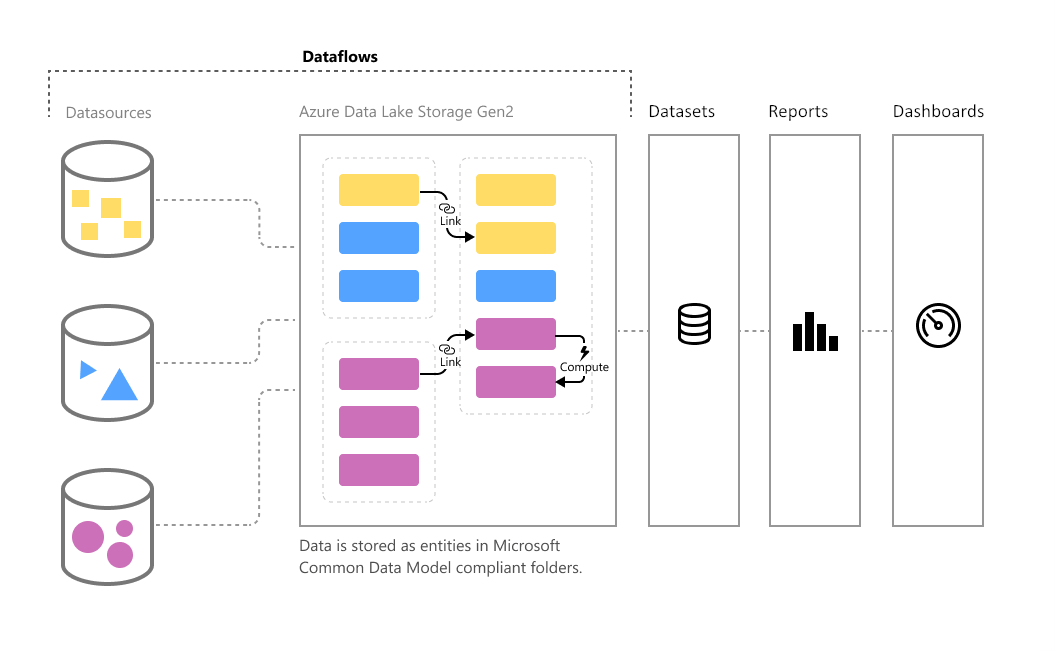
Потоки данных предназначены для поддержки следующих сценариев:
Создайте логику повторного использования преобразования, которую можно использовать во многих семантических моделях и отчетах в Power BI. Потоки данных повышают повторное использование базовых элементов данных, предотвращая необходимость создания отдельных подключений к облачным или локальным источникам данных.
Сохраняйте данные в собственном хранилище Azure Data Lake 2-го поколения, что позволяет предоставлять их другим службам Azure за пределами Power BI.
Создайте один источник истины, курируемый из необработанных данных с помощью стандартных отраслевых определений, которые могут работать с другими службами и продуктами в Power Platform. Поощряйте их, удаляя доступ аналитиков к базовым источникам данных.
Повышение безопасности в базовых источниках, данных путем предоставления данных создателям отчетов в потоках данных. Этот подход позволяет ограничить доступ к базовым источникам данных, уменьшая нагрузку на исходные системы, и дает администраторам более точное управление операциями обновления данных.
Если вы хотите работать с большими объемами данных и выполнять ETL в большом масштабе, потоки данных с помощью Power BI Premium масштабируется более эффективно и обеспечивают большую гибкость. Потоки данных поддерживают широкий спектр облачных и локальных источников.
Вы можете использовать Power BI Desktop и служба Power BI с потоками данных для создания семантических моделей, отчетов, панелей мониторинга и приложений, использующих общую модель данных. Из этих ресурсов вы можете получить подробные сведения о бизнес-действиях. Планирование обновления потока данных управляется непосредственно из рабочей области, в которой был создан поток данных, как и в семантических моделях.
Примечание. Потоки данных могут быть недоступны в служба Power BI для всех клиентов DoD для государственных организаций.
5. Архитектурные решения для обработки потоковых данных
Под потоковыми данными понимаются непрерывно поступающие и быстро изменяющиеся информационные потоки, генерируемые различными источниками, такими как сенсоры, логи приложений, социальные сети, интернет вещей и многие другие. Эти данные часто характеризуются высокой скоростью поступления, большим объемом и коротким временем жизни.
Важность потоковых данных заключается в их способности предоставлять актуальную информацию в режиме реального времени. Они позволяют нам вовремя реагировать на события, принимать обоснованные решения и адаптироваться к меняющимся условиям. Эта актуальность имеет особенное значение во многих областях, начиная от бизнеса и финансов и заканчивая медициной и научными исследованиями.
С каждым днем интерес к обработке потоковых данных становится все более заметным. Зонами, связанными с обработкой данных в высокоскоростных потоках.
5.1. Основные принципы потоковой обработки данных.
Потоковая обработка данных — это метод обработки информации, при котором данные анализируются по мере их непрерывного поступления, обеспечивая оперативное реагирование и принятие решений. В сравнении с традиционной пакетной обработкой, где данные группируются и обрабатываются в определенные интервалы времени (пакеты), потоковая обработка работает в режиме реального времени, что позволяет извлекать ценную информацию из потока данных немедленно.
Принцип работы потоковой обработки данных:
Захват данных: Процесс начинается с захвата данных из источников. Это могут быть сенсоры, приложения, веб-сервисы и другие источники, генерирующие потоки данных. Важно обеспечить надежный и эффективный сбор данных для последующей обработки.
Агрегация и преобразование: По мере поступления, данные агрегируются и преобразуются для более удобной обработки. Это может включать в себя фильтрацию, преобразование формата, агрегацию и другие операции, необходимые для получения информации в желаемом виде.
Обработка: Затем данные направляются в процесс обработки. Здесь применяются алгоритмы и логика, которые анализируют данные, выявляют закономерности, аналитические тренды и аномалии. Это может быть что-то такое, как выявление атак в сети, мониторинг состояния оборудования или анализ поведения пользователей.
Принятие решений: После обработки данных система может принимать решения на основе полученных результатов. Это может быть автоматическое действие, например, автоматическая коррекция производственного процесса при выявлении несоответствий, или предоставление информации человеку для принятия решения, например, в случае анализа финансовых данных.
Действие и хранение: В зависимости от результата обработки, система может выполнять дополнительные действия. Это может быть отправка уведомлений, запись данных в хранилище, архивирование информации или внесение изменений в рабочие процессы.
Пример реального сценария:
Представьте систему мониторинга транспорта для городского управления. Сенсоры на автомобилях непрерывно передают информацию о скорости, местоположении, состоянии транспортных потоков и дорог. Эти данные немедленно передаются в систему потоковой обработки.
На этапе обработки система анализирует данные, выявляет заторы движения, определяет области повышенного трафика и выявляет аномалии в движении. На основе этих данных система автоматически рассчитывает оптимальные маршруты, предупреждает об аварийных ситуациях и предоставляет водителям рекомендации для избежание заторов.
Таким образом, потоковая обработка данных в данном сценарии позволяет городским органам управления реагировать на транспортные ситуации мгновенно, оптимизировать движение и повышать безопасность дорожного движения.
5.2. Преимущества и недостатки по сравнению с пакетной обработкой.
Преимущества потоковой обработки данных:
Реальное время: Одним из наиболее значимых преимуществ потоковой обработки является способность анализировать данные практически в режиме реального времени. Это особенно важно для сценариев, требующих мгновенной реакции на события, таких как финансовые операции или мониторинг состояния оборудования.
Актуальность: Потоковая обработка позволяет получать актуальную информацию о состоянии системы или событиях, происходящих в окружающем мире. Это важно для принятия оперативных решений и реагирования на изменения в реальном времени.
Эффективность ресурсов: Обработка данных по мере их поступления позволяет избежать накопления больших объемов данных и ресурсоемких операций в памяти. Это способствует более эффективному использованию вычислительных ресурсов.
Снижение задержек: За счет анализа данных непосредственно при их поступлении можно снизить задержки в реакции на события. Это особенно важно для систем, где даже небольшая задержка может иметь критические последствия.
Недостатки потоковой обработки данных:
Сложность обработки: Обработка данных в реальном времени может быть сложной задачей, требующей оптимизации алгоритмов и вычислительных процессов для достижения приемлемой производительности.
Управление задержками: В некоторых сценариях задержки между поступлением данных и их обработкой могут быть недопустимо большими. Управление этими задержками требует специализированных методов.
Сложность отладки: Отладка и тестирование потоковых систем может быть более сложными, чем в случае пакетной обработки, из-за динамичной природы данных и асинхронности процессов.
Начало формы
Контрольные вопросы
1. Что такое поток?
2. Чем поток отличается от процесса?
3. Как запустить поток после завершения другого потока?
4. Как присвоить потоку имя?
5. Как остановить выполнение потока?
ДОМАШНЕЕ ЗАДАНИЕ
Изучить теоретический материал по данной теме.
Ответить письменно на контрольные вопросы.
Внимание! Выполнить домашнее задание в тетради. Отчёт отослать на адрес электронной почты преподавателя.
Перечень рекомендуемых учебных изданий, Интернет-ресурсов, дополнительной литературы.
Основные источники:
Информатика. 10 класс : учебник для общеобразоват. организаций: базовый и углубленный уровни / [А.Г.Гейн , А.Б Ливчак, А.И. Сенокосов, Н.А. Юнерман]. – 4-е изд. – М. : Просвещение, 2018. – 272 с. : ил. – ISBN 978-5-09-058130-1
Информатика. 11 класс : учебник для общеобразоват. организаций: базовый и углубленный уровни / [А.Г.Гейн, А.И. Сенокосов]. – 6-е изд. – М. : Просвещение, 2019. – 336 с. : ил. – ISBN 978-5-09-072326-8.
Электронные источники:
Зимин, В. П. Информатика. Лабораторный практикум в 2 ч. Часть 1 : учебное пособие для среднего профессионального образования / В. П. Зимин. — 2-е изд., испр. и доп. — Москва : Издательство Юрайт, 2023. — 126 с. — (Профессиональное образование). — ISBN 978-5-534-11851-3. — Текст : электронный // Образовательная платформа Юрайт [сайт]. — URL: https://urait.ru/bcode/514893
Зимин, В. П. Информатика. Лабораторный практикум в 2 ч. Часть 2 : учебное пособие для среднего профессионального образования / В. П. Зимин. — 2-е изд. — Москва : Издательство Юрайт, 2023. — 153 с. — (Профессиональное образование). — ISBN 978-5-534-11854-4. — Текст : электронный // Образовательная платформа Юрайт [сайт]. — URL: https://urait.ru/bcode/514918
Мойзес, О. Е. Информатика. Углубленный курс : учебное пособие для среднего профессионального образования / О. Е. Мойзес, Е. А. Кузьменко. — Москва: Издательство Юрайт, 2020. — 164 с. — (Профессиональное образование). — ISBN 978-5-534-07980-7. — Текст : электронный // ЭБС Юрайт [сайт]. — URL: https://urait.ru/bcode/455803 .
Советов, Б. Я. Информационные технологии : учебник для среднего профессионального образования / Б. Я. Советов, В. В. Цехановский. — 7-е изд., перераб. и доп. — Москва : Издательство Юрайт, 2020. — 327 с. — (Профессиональное образование). — ISBN 978-5-534-06399-8. — Текст: электронный // ЭБС Юрайт [сайт]. — URL: https://urait.ru/bcode/450686 .
Новожилов, О. П. Информатика в 2 ч. Часть 1 : учебник для среднего профессионального образования / О. П. Новожилов. — 3-е изд., перераб. и доп. — Москва: Издательство Юрайт, 2020. — 320 с. — (Профессиональное образование). — ISBN 978-5-534-06372-1. — Текст : электронный // ЭБС Юрайт [сайт]. — URL: https://urait.ru/bcode/448995 .
Новожилов, О. П. Информатика в 2 ч. Часть 2 : учебник для среднего профессионального образования / О. П. Новожилов. — 3-е изд., перераб. и доп. — Москва: Издательство Юрайт, 2020. — 302 с. — (Профессиональное образование). — ISBN 978-5-534-06374-5. — Текст : электронный // ЭБС Юрайт [сайт]. — URL: https://urait.ru/bcode/448996
Гаврилов, М. В. Информатика и информационные технологии : учебник для среднего профессионального образования / М. В. Гаврилов, В. А. Климов. — 4-е изд., перераб. и доп. — Москва: Издательство Юрайт, 2020. — 383 с. — (Профессиональное образование). — ISBN 978-5-534-03051-8. — Текст: электронный // ЭБС Юрайт [сайт]. — URL: https://urait.ru/bcode/449286
Дополнительные источники:
Филимонова, Е. В. Информатика и информационные технологии в профессиональной деятельности: учебник / Е. В. Филимонова. – Москва: Юстиция, 2019. – 213 с. – (Среднее профессиональное образование). - ISBN 978-5-4365-2703-1.
Цветкова М.С., Информатика. Практикум для профессий и специальностей естественно-научного и гуманитарного профилей: : учеб. пособие для студентов учреждений сред. проф. образования / М.С. Цветкова, И.Ю. Хлобыстова. - 5-е изд., стер. - М. : Издательский центр "Академия", 2019. - 240 с. ISBN 978-5-4468-7901-4
Электронные источники:
Гаврилов, М. В. Информатика и информационные технологии : учебник для среднего профессионального образования / М. В. Гаврилов, В. А. Климов. — 4-е изд., перераб. и доп. — Москва : Издательство Юрайт, 2021. — 383 с. — (Профессиональное образование). — ISBN 978-5-534-03051-8. — Текст : электронный // Образовательная платформа Юрайт [сайт]. — URL: https://urait.ru/bcode/469424
Акопов, А. С. Компьютерное моделирование : учебник и практикум для среднего профессионального образования / А. С. Акопов. — Москва : Издательство Юрайт, 2023. — 389 с. — (Профессиональное образование). — ISBN 978-5-534-10712-8. — Текст : электронный // Образовательная платформа Юрайт [сайт]. — URL: https://urait.ru/bcode/517999
Демин, А. Ю. Информатика. Лабораторный практикум : учебное пособие для среднего профессионального образования / А. Ю. Демин, В. А. Дорофеев. — Москва : Издательство Юрайт, 2023. — 133 с. — (Профессиональное образование). — ISBN 978-5-534-07984-5. — Текст : электронный // Образовательная платформа Юрайт [сайт]. — URL: https://urait.ru/bcode/516857
Преподаватель: Владимир Александрович Волков E-mail: sia_skif@mail.ru
Вебинар для учителей

🎓 Свидетельство об участии ✨БЕСПЛАТНО!✨



