


Россия, Москва


СДЕЛАЙТЕ СВОИ УРОКИ ЕЩЁ ЭФФЕКТИВНЕЕ, А ЖИЗНЬ СВОБОДНЕЕ
Благодаря готовым учебным материалам для работы в классе и дистанционно
Скидки до 50 % на комплекты
только до
Готовые ключевые этапы урока всегда будут у вас под рукой
Организационный момент
Проверка знаний
Объяснение материала
Закрепление изученного
Итоги урока

Была в сети 29.12.2025 15:39

Варова Вера Витальевна
ассистент кафедры переводоведения и когнитивной лингвистики МГОУ
 1 093
 63 602

Местоположение
Специализация
Презентация "Области применения информационных технологий в лингвистике"
Категория:
Информатика
17.03.2021 11:13

Просмотр содержимого документа
«Презентация "Области применения информационных технологий в лингвистике"»

ОБЛАСТИ ПРИМЕНЕНИЯ ИНФОРМАЦИОННЫХ ТЕХНОЛОГИЙ В ЛИНГВИСТИКЕ
Содержание
Автоматический анализ
и синтез звучащей речи
01
Автоматическое распознавание текста
02
Автоматическое аннотирование и реферирование текста
03
Автоматический анализ и синтез текста
04
Автоматический анализ и синтез звучащей речи
Основные термины
Дигитализация текстов - переведение языкового материала,
существующего в печатном или устном виде, в цифровую форму.
Автоматический синтез звучащей речи представляет собой обратный процесс преобразования печатного текста, существующего в цифровой форме, в звучащий текст на естественном человеческом языке.
Спектрограмма — фотографическое изображение звуков.

Варианты спектограмм

Программы, в которых применяются средства автоматического анализа речи.
- VoiceNavigator https://www.speechpro.ru/product/sistemy-upravleniya-kachestvom-i-avtomatizatsii/voicenavigator
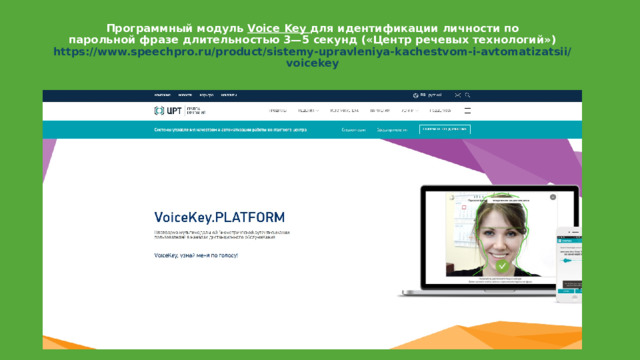
Программный модуль Voice Key для идентификации личности по парольной фразе длительностью 3—5 секунд («Центр речевых технологий») https://www.speechpro.ru/product/sistemy-upravleniya-kachestvom-i-avtomatizatsii/voicekey
Программы для перевода речи в текст
Транскрибация – это автоматический или ручной перевод речи в текст, точнее, запись аудио или видео-файла в текстовом виде.
- Сайт speechpad.ru https://speechpad.ru/
- Голосовой ввод в GOOGLE документах для перевода речи в текст
- Сервис dictation.io https://dictation.io/speech
- RealSpeaker https://realspeaker.net/
- Speechnotes https://play.google.com/store/apps/details?id=co.speechnotes.speechnotes&hl=ru
- Dragon Dictation https://www.nuance.com/dragon/support/dragon-naturallyspeaking.html
- oТранскрибировать https://otranscribe.com/
- Средство синтеза речи https://www.textfromtospeech.com/ru/text-to-voice/

Автоматическое распознавание текста
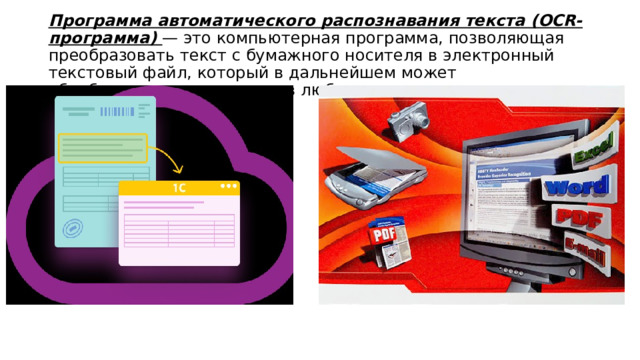
Программа автоматического распознавания текста (OCR-программа) — это компьютерная программа, позволяющая преобразовать текст с бумажного носителя в электронный текстовый файл, который в дальнейшем может обрабатываться человеком в любом текстовом редакторе.
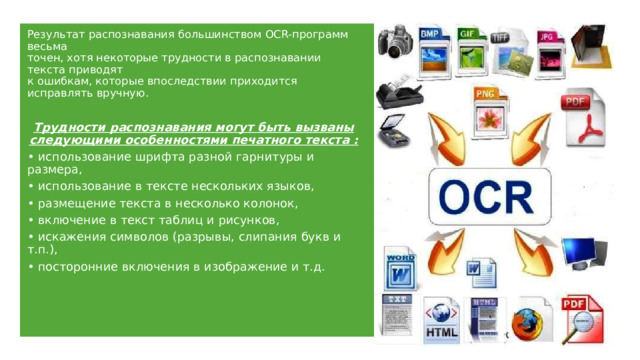
Результат распознавания большинством OCR-программ весьма точен, хотя некоторые трудности в распознавании текста приводят к ошибкам, которые впоследствии приходится исправлять вручную.
Трудности распознавания могут быть вызваны следующими особенностями печатного текста :
• использование шрифта разной гарнитуры и размера,
• использование в тексте нескольких языков,
• размещение текста в несколько колонок,
• включение в текст таблиц и рисунков,
• искажения символов (разрывы, слипания букв и т.п.),
• посторонние включения в изображение и т.д.

Программы для автоматического распознавания и преобразования текста
- Microsoft Office Document Imaging https://ru.wikipedia.org/wiki/Microsoft_Office_Document_Imaging
- ABBYYFinereader10.0.102.95 https://softoroom.net/ptopic826.html
- Scanitto https://www.scanitto.com/ru/
- BlindScanner https://www.blindscanner.com/ru/
- OCRCUNEIFORM https://ocr-cuneiform.softok.info/
- Readiris Readiris pro скачать бесплатно русская версия (softok.info)
- Adobe Scan Обзор Adobe Scan - приложение для перевода фотографий документов в отсканированный вид | Пикабу (pikabu.ru)
Автоматическое аннотирование и реферирование текста
Реферат определяется как связный текст, который кратко выражает:
• центральную тему;
• предмет;
• цель;
• методы;
• результаты исследования.
Виды рефератов
Различают следующие виды рефератов:
• связный текст — новое текстовое образование, порождаемое на
основе логико-смыслового анализа исходного текста;
• реферат-клише — модификация заданной клишированной структуры, пустые ячейки которой заполняются после анализа заданного текста;
• квазиреферат — перечень наиболее информативных предложений текста.
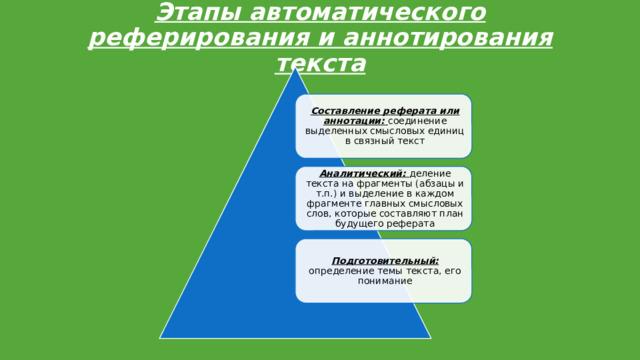
Этапы автоматического реферирования и аннотирования текста
Составление реферата или аннотации: соединение выделенных смысловых единиц в связный текст
Аналитический: деление текста на фрагменты (абзацы и т.п.) и выделение в каждом фрагменте главных смысловых слов, которые составляют план будущего реферата
Подготовительный: определение темы текста, его понимание

Главными смысловыми единицами исходного текста выступают:
- Ключевое слово — знаменательное слово, относящееся к основ-
ному содержанию текста и повторяющееся в нем несколько раз.
- Ключевое словосочетание — сочетание слов, среди которых есть одно
или несколько ключевых.
- Ключевое предложение — предложение, которое содержит несколько (два и более) ключевых слов.
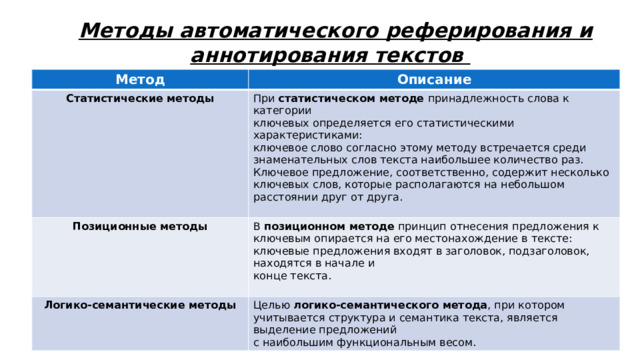
Методы автоматического реферирования и аннотирования текстов
Метод
Описание
Статистические методы
При статистическом методе принадлежность слова к категории
Позиционные методы
ключевых определяется его статистическими характеристиками:
В позиционном методе принцип отнесения предложения к ключевым опирается на его местонахождение в тексте: ключевые предложения входят в заголовок, подзаголовок, находятся в начале и
Логико-семантические методы
ключевое слово согласно этому методу встречается среди знаменательных слов текста наибольшее количество раз. Ключевое предложение, соответственно, содержит несколько ключевых слов, которые располагаются на небольшом расстоянии друг от друга.
конце текста.
Целью логико-семантического метода , при котором учитывается структура и семантика текста, является выделение предложений
с наибольшим функциональным весом.

Примеры систем автоматического реферирования и аннотирования текстов
- ОРФО https://orfo.ru/
- т-КОНСПЕКТУС https://tconspectus.pythonanywhere.com/sumysum
- ISTIO https://istio.com/
- Readability http://ru.readability.io/
- Вордстат https://wordstat.yandex.ru/
- TextReferent http://www.analyst.ru/index.php?lang=eng&dir=content/downloads/
- Wordassociations https://wordassociations.net/ru/
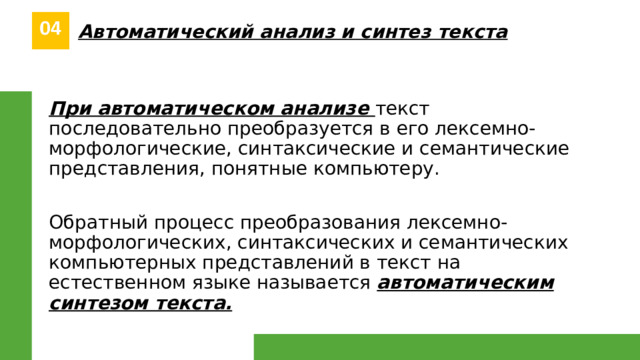
Автоматический анализ и синтез текста
При автоматическом анализе текст последовательно преобразуется в его лексемно-морфологические, синтаксические и семантические представления, понятные компьютеру.
Обратный процесс преобразования лексемно-морфологических, синтаксических и семантических компьютерных представлений в текст на естественном языке называется автоматическим синтезом текста.

Автоматический анализ текста включает ряд этапов:
1) графематический анализ: выделение границ слов, предложений,
абзацев и других элементов текста (например, врезок в газетном
тексте);
2) морфологический анализ: определение исходной формы каждого
использованного в тексте слова и набора морфологических характеристик
этого слова;
3) синтаксический анализ: выявление грамматической структуры
предложений текста;
4) семантический анализ: определение смысла фраз.
Графематический анализ
Графематический анализ определяется также как токенизация (от англ. token = отдельное слово, фраза или любой другой значимый элемент текста).
Формальными сигналами границ текстовых элементов выступают разделители различного рода: пробелы, обозначающие границы между словами, прописные буквы и знаки препинания, обозначающие границы между предложениями и составными частями предложений, абзацные отступы, обозначающие границы между связанными по смыслу группами предложений и т.п.

Морфологический анализ
При морфологическом анализе каждое использованное в тексте слово возводится к его исходной форме и определяется набор морфологических характеристик текстовой формы слова: часть речи; род, число и падеж для существительных, число и лицо для глаголов и т.п.
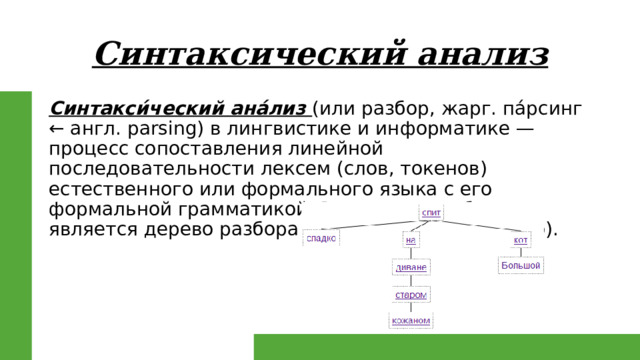
Cинтаксический анализ
Синтакси́ческий ана́лиз (или разбор, жарг. па́рсинг ← англ. parsing) в лингвистике и информатике — процесс сопоставления линейной последовательности лексем (слов, токенов) естественного или формального языка с его формальной грамматикой. Результатом обычно является дерево разбора (синтаксическое дерево).
Семантический анализ представляет собой, пожалуй, наиболее сложное направление автоматического анализа текста.
В этом случае требуется установление семантических отношений между словами в тексте, объединение различных языковых выражений, относящихся к одному и тому же понятию, и т.п.
Ссылки на онлайн-программы для осуществления автоматического анализа и синтеза текста
1. Морфологический анализ текста (программа Mystem):
http:// web - corpora.net/ wsgi / mystemplus.wsgi / mystemplus / mystem /results
2. Онлайн толковые словари и словари синонимов, энциклопедии русского языка: http://slovonline.ru /
3. Электронный словарь Мультитран: https:// www.multitran.com/m.exe?a=1&l1=2&l2=1
4. Программа семантического анализа текста Advego: https://advego.com /
5. Сервис фоносемантического анализа слов: https:// psi-technology.net/servisfonosemantika.php
6. Программа семантического анализа текста Miratext: https:// miratext.ru/seo_analiz_text
7. Программа семантического анализа текста Istio: https://istio.com/rus/text/analyz /
Используемые источники:
Щипицина Л.Ю. Информационные технологии в лингвистике : учеб. пособие/ Л.Ю. Щипицина. — М. : ФЛИНТА : Наука, 2013. —128 с.
Материалы сайтов (иллюстрация):
- http://zavelos.ru/forum/69804-win-3d-spektrogramma
- https://www.speechpro.ru/product/sistemy-upravleniya-kachestvom-i-avtomatizatsii/voicekey/specification
- https://otranscribe.com/
- https://softoroom.net/ptopic826.html
Вопросы?
Варова Вера Витальевна, ассистент кафедры переводоведения и когнитивной лингвистики Московского государственного областного университета
vv.varova@mgou.ru
СПАСИБО ЗА ВНИМАНИЕ!
Вебинар для учителей

🎓 Свидетельство об участии ✨БЕСПЛАТНО!✨



