


Казахстан, Чунджа


СДЕЛАЙТЕ СВОИ УРОКИ ЕЩЁ ЭФФЕКТИВНЕЕ, А ЖИЗНЬ СВОБОДНЕЕ
Благодаря готовым учебным материалам для работы в классе и дистанционно
Скидки до 50 % на комплекты
только до
Готовые ключевые этапы урока всегда будут у вас под рукой
Организационный момент
Проверка знаний
Объяснение материала
Закрепление изученного
Итоги урока

Был в сети 05.11.2021 07:20

Якупова Малика Турсуновна
психолог
 7 678
 7 583

Местоположение
Специализация
Математические методы
Категория:
Психологу
27.01.2021 14:20

Просмотр содержимого документа
«Математические методы»
1.Роль математической статистики в психологической науке.Математика делает обозримыми длинные и подчас туманные словесные описания, проясняет и экономит мысль. Математические методы позволяют обоснованно прогнозировать будущие события. В общем, польза от применения математики велика, но и труда на ее освоение требуется много. Однако он окупается сполна.Слово «статистика» часто ассоциируется со словом «математика», и это пугает студентов гуманитарных специальностей, связывающих это понятие со сложными формулами, требующими высокого уровня абстрагирования, как следствие, появляются затруднения, боязнь и предубеждение в возможности ими овладеть. Вместе с тем по мере накопления практического опыта, базы данных эмпирических исследований неизбежно встает вопрос их обобщения, выявления тенденций, динамики, характерных черт, особенностей, которые невозможно обоснованно интерпретировать, не используя математические методы количественного анализа.Основные принципы использования математико-статистических методов в психологии: · без использования и владения аппаратом математической статистики вы не можете считать себя квалифицированным психологом;· аппарат математической статистики в психологии лишь инструмент для обоснования достоверности ваших выводов, и математические критерии никогда не рассматриваются в психологии в качестве абсолютной истины. В то же время игнорирование их не допустимо;· от того, как вы используете математико-статистический инструментарий, зависят ваши выводы (в какой мере ваши выводы могут быть оспорены другими исследователями при использовании других методов);· начинать необходимо с четкого уяснения базовых понятий, определений. В математической статистике они достаточно четко определены и не допускают двойственных толкований;· в каждом методе, формуле важно понять смысл того, для чего они используются в психологическом исследовании, какие результаты они дают и каким образом их можно и должно будет интерпретировать.Изучая основы статистики, не следует бояться математических формул, без знания которых, несомненно, не обойтись. Главное – надо понимать, какую психологическую реальность они описывают, какой психологический смысл в них содержится, и тогда за математическими формулами, уровнями достоверности (статистической значимости), критическими значениями коэффициентов откроются психологические реалии, их значение и смысл.
2. Основные понятия статистики используемые в психологии Статистика в психологии (statistics in psychology)Первое применение С. в психологии часто связывают с именем сэра Фрэнсиса Гальтона. В психологии под«статистикой» понимается применение количественных мер и методов для описания и анализа результатовпсихол. исслед. Психологии как науке С. необходима. Регистрация, описание и анализ количественных данныхпозволяют проводить обоснованные сравнения, опирающиеся на объективные критерии. Применяемая впсихологии С. обычно состоит из двух разделов: описательной (дескриптивной) статистики и теориистатистического вывода.Описательная С. включает в себя методы орг-ции, суммирования и описания данных. Дескриптивныепоказатели позволяют быстро и эффективно представлять большие совокупности данных. К наиболее частоиспользуемым описательным методам относятся частотные распределения, меры центральной тенденции имеры относительного положения. Регрессия и корреляции применяются для описания связей междупеременными.Частотнее распределение показывает, сколько раз каждый качественный или количественный показатель(либо интервал таких показателей) встречается в массиве данных. Кроме того, нередко приводятсяотносительные частоты — процент ответов каждого типа. Частотное распределение обеспечивает быстроепроникновение в структуру данн х, к-рого было бы трудно достичь, работая непосредственно с первичнымиданными. Для наглядного представления частотных данных часто используются разнообразные видыграфиков.Меры центральной тенденции — это итоговые С., описывающие то, что яв-ся типичным для распределения. Мода определяется как наиболее часто встречающееся наблюдение (значение, категория и т. д.). Медиана — это значение, к-рое делит распределение пополам, так что одна его половина включает все значения вышемедианы, а другая — все значения ниже медианы. Среднее вычисляется как среднее арифметическое всехнаблюденных значений. Какая из мер — мода, медиана или среднее — будет лучше всего описыватьраспределение, зависит от его формы. Если распределение симметричное и унимодальное (имеющее однумоду), среднее медиана и мода будут просто совпадать.
3. Измерения в психологии. Измерение – это процедура, с помощью которой измеряемый объект сравнивается с некоторым эталоном, в результате чего получается численное выражение в определённой масштабе или шкале.Единица измерения – условный эталон для осуществления тех или иных измерительных процедур.В естественных науках и технике существуют стандартные единицы измерения (градус, метр, ампер и т.д.). Психологические переменные (за единичными исключениями) не имеют собственных измерительных единиц. В психологии измерение осуществляется с помощью кодирования.Кодирование – это такая операция, с помощью которой экспериментальным данным придаётся форма числового сообщения (кода).
4. Понятие психологического измерения. Измерение – это процедура, с помощью которой измеряемый объект сравнивается с некоторым эталоном, в результате чего получается численное выражение в определённой масштабе или шкале.Единица измерения – условный эталон для осуществления тех или иных измерительных процедур.В естественных науках и технике существуют стандартные единицы измерения (градус, метр, ампер и т.д.). Психологические переменные (за единичными исключениями) не имеют собственных измерительных единиц. В психологии измерение осуществляется с помощью кодирования.Кодирование – это такая операция, с помощью которой экспериментальным данным придаётся форма числового сообщения (кода).
5. Типы шкал измерения. В теории измерений рассматривают 5 различных типов шкал:- шкалы наименований;- шкалы интервалов (шкалы разностей);- шкалы отношений;- шкалы порядка (шкалы рангов);- абсолютные шкалы.Шкалы наименований –это качественные шкалы, которые соответствуют свойствам только с отношениями эквивалентности. К этим свойствам нельзя применить термин «размер», но они могут быть определены и идентифицированы. Например, наименование или обозначение цвета по атласу цветов.Шкалы порядка –соответствуют свойствам, для которых могут быть установлены отношения эквивалентности и отношения порядкапо возрастанию или уменьшению количественного проявления свойства, но единицы измерения ввести нельзя. Это шкалы с балльной оценкой (сила землетрясения, сила ветра, твердость минералов и металлов).Шкалы интервалов – соответствуют свойствам с отношениями эквивалентности, порядка и аддитивности. Шкалы интервалов имеют условный ноль, заданные значения интервалов и единицу измерения.Шкалы отношений –соответствуют свойствам с отношениями эквивалентности, порядка и аддитивности. Шкалы отношений считаются наиболее совершенными, так как имеют естественный ноль и единицы измерения, которые принимают по согласованию. Шкалы порядка –соответствуют свойствам с отношениями эквивалентности и порядка(по возрастанию или уменьшению количественного проявления свойства), но единицы измерения ввести нельзя. Эти величины не измеряют, а оценивают. Шкалы порядка имеют балльную оценку. Например, шкала силы землетрясения, шкалы твердости минералов и металлов, шкалы серых и синих эталонов оценки устойчивости окраски и др.Абсолютные шкалы -соответствуют свойствам с отношениями эквивалентности, порядка и аддитивности, имеющие естественное однозначное определение единицы измерения. Например, шкала измерения плоских углов в радианах (радиан – это центральный угол, соответствующий дуге, длина которой равна ее радиусу).
6.Цели и задачи курса математические методы в психологии. Главная цель изучения учебной дисциплины "Математические методы в психологии" — сформировать у студентов представления о возможностях применения математики в изучении психологических явлений и овладение аппаратом математической статистики в приложении ее для обработки и анализа результатов психологических исследований.К основным задачам курса «Математические методы в психологии»можно отнести следующие:- Сформировать целостное представление о необходимости и возможностях математико-статистического анализа результатов психологического исследования.- Сформировать и закрепить навыки описания результатов и проверки гипотез, которые не требуют использования электронно-вычислительных машин.- Сформировать представления о дисперсионном и факторном анализе. Знать простейшие алгоритмы построения дисперсионного анализа. Понимать результаты факторного анализа.- Дать общие сведения о возможностях более сложных программ современных видов математико-статистического анализа результатов исследования.- Ознакомиться с различными направлениями и основными результатами математического моделирования психологических явлений.
7.Генеральная совокупность и выборка. Генеральная совокупность[1] (в англ. — population) — совокупность всех объектов (единиц), относительно которых учёный намерен делать выводы при изучении конкретной проблемы.Генеральная совокупность состоит из всех объектов, которые подлежат изучению. Состав генеральной совокупности зависит от целей исследования. Иногда генеральная совокупность - это все население определённого региона (например, когда изучается отношение потенциальных избирателей к кандидату), чаще всего задаётся несколько критериев, определяющих объект исследования. Например, мужчины 30-50 лет, использующие бритву определённой марки не реже раза в неделю, и имеющие доход не ниже $100 на одного члена семьи.Выборка или выборочная совокупность — множество случаев (испытуемых, объектов, событий, образцов), с помощью определённой процедуры выбранных из генеральной совокупности для участия в исследовании.Характеристики выборки: Качественная характеристика выборки – кого именно мы выбираем и какие способы построения выборки мы для этого используем.Количественная характеристика выборки – сколько случаев выбираем, другими словами объём выборки.Необходимость выборкиОбъект исследования очень обширный. Например, потребители продукции глобальной компании – огромное количество территориально разбросанных рынков. Существует необходимость в сборе первичной информации.
8.Репрезентативность выборки. Репрезентативность (представительность) выборки — это способность выборки воспроизводить определенные характеристики генеральной совокупности в пределах допустимых погрешностей. Выборку называют репрезентативной, если результат измерения определенного параметра для данной выборки совпадает с учетом допустимой погрешности с известным результатом измерения генеральной совокупности. Если выборочное измерение отклоняется от известного параметра генеральной совокупности больше выбранного уровня погрешности, то такая выборка считается нерепрезентативной.
9.Методы отбора выборки. В зависимости от методики формирования выборочной совокупности различают следующие основные виды выборки:собственно случайную;механическую;типическую (стратифицированную, районированную);серийную (гнездовую);комбинированную;многоступенчатую;многофазную;взаимопроникающую.
10.Метод случайного рандомизированного отбора выборки. Случайные методы отбора применяют, как правило, при небольшой численности генеральной совокупности при условии, что имеется полный список (или перечень) ее единиц. Такой список называют основой выборки. Основа выборки должна быть:– полной (т. е. включать все единицы генеральной совокупности);– точной (т. е., с одной стороны, не содержать не существующих единиц, и, с другой стороны позволять идентифицировать включенные в список единицы);– без дублирования единиц генеральной совокупности;– адекватной (т. е. соответствовать генеральной совокупности: в ней должны быть представлены единицы, относящиеся к объекту исследования)[2];– удобной для использования (основа должна быть представлена единым списком, быть пронумерованной). От качества основы выборки во многом зависит качество выборочной совокупности.
11.Метод стратифицированного случайного отбора. Стратифицированный отбор. Вероятностная выборка с любой техникой отбора называется стратифицированной, если процедуре отбора предшествует выделение в генеральной совокупности качественно однородных частей (подсовокупностей), называемых стратами. Страты — это однородные части обширной разнородной генеральной совокупности. Отбор единиц выборочной совокупности в дальнейшем осуществляется из выделенных страт.Дифференциация генеральной совокупности на страты связана с предметом исследования. Стратифицированный отбор необходим, когда генеральная совокупность неоднородна по значимым для исследования характеристикам.Стратификация генеральной совокупности может осуществляться по одному или нескольким стратифицирующим признакам. Стратифицирующий признак — это признак, по значению которого производится стратификация Важно правильно определиться с выбором стратифицирующего признака (признаков). Неправильный выбор стратифицирующего признака не повышает репрезентативность выборки, а наоборот, понижает ее.
12.Зависимые и независимые выборки. Зависимые и независимые выборкиПри сравнении двух (и более) выборок важным параметром является их зависимость. Если можно установить гомоморфную пару (то есть, когда одному случаю из выборки X соответствует один и только один случай из выборки Y и наоборот) для каждого случая в двух выборках (и это основание взаимосвязи является важным для измеряемого на выборках признака), такие выборки называются зависимыми. Примеры зависимых выборок:пары близнецов,два измерения какого-либо признака до и после экспериментального воздействия,мужья и жёны и т. п.В случае, если такая взаимосвязь между выборками отсутствует, то эти выборки считаются независимыми, например:мужчины и женщины,психологи и математики.Соответственно, зависимые выборки всегда имеют одинаковый объём, а объём независимых может отличаться.Репрезентати́вность — соответствие характеристик выборки характеристикам популяции или генеральной совокупности в целом. Репрезентативность определяет, насколько возможно обобщать результаты исследования с привлечением определённой выборки на всю генеральную совокупность, из которой она была собрана.Также, репрезентативность можно определить как свойство выборочной совокупности представлять параметры генеральной совокупности, значимые с точки зрения задач исследования.Предположим, совокупность — это все учащиеся школы (600 человек из 20 классов, по 30 человек в каждом классе). Предмет изучения — отношение к курению. Выборка, состоящая из 60 учеников старших классов, гораздо хуже представляет совокупность, чем выборка из тех же 60 человек, в которую войдут по 3 ученика из каждого класса. Главной причиной тому — неравное возрастное распределение в классах. Следовательно, в первом случае репрезентативность выборки низкая, а во втором случае репрезентативность высокая (при прочих равных условиях).
13.Номинальная шкала. Номинальная шкала (шкала наименований) –это шкала, классифицирующая по названию. Название не измеряется количественно, оно лишь позволяет отличить один объект от другого. Простейшая форма номинальной шкалы, это - дихотомическая шкала, которая имеет только 2 значения (да – нет, мужчина – женщина, купил – не купил).
14.Порядковая шкала. Порядковая (ранговая) шкала - отображение отношений порядка. Единственно возможные отношения между объектами измерения в данной шкале – это больше/меньше, лучше/хуже. ... Кроме места, порядковая шкала дает возможность узнать и конкретные результаты участника соревнований или конкурса (если процедура конкурса не предполагает закрытость информации: например, тендер).
15.Интервальная шкала. Интервальная шкала - помимо отношений указанных для шкал наименования и порядка, отображает отношение расстояния (разности) между объектами. Разности между соседними точками в этой шкале равны. Большинство психологических тестов содержат нормы, которые и являются образцом интервальной шкалы. Коэфициент интеллекта, результаты теста FPI, шкала градусов цельсия - всё это интервальныешкалы.
16.Абсолютная шкала. Абсолютная шкала – в которых единственными допустимыми преобразованиями являются тождественные преобразования .Абсолютные шкалы применяются, например, для измерения количества объектов, предметов, событий, решений и т.п. В качестве шкальных значений при измерении количества объектов используются натуральные числа, когда объекты представлены целыми единицами, и действительные числа, если кроме целых единиц присутствуют и части объектов.
17.Правила ранжирования. 1. Меньшему значению начисляется меньший ранг. Наименьшему значению начисляется ранг 1. Наибольшему значению начисляется ранг, соответствующий количеству ранжируемых значений. Например, если п= 7, то набольшее значение получит ранг 7, за возможным исключением для тех случаев, которые предусмотрены правилом 2..2. Если несколько значений равны, им начисляется ранг, представляющий собой среднее значение из тех рангов, которые они получили бы, если бы не были равны.3. Следующему за этой парой испытуемому студенту О. В. присваивается ранг 6 и т.д. Эго правило основано на соглашении соблюдении одинаковой суммы рангов для связанных и несвязанных рангов.
18.Методы первичной обработки данных. Первичная обработканацелена на упорядочивание информации об объекте и предмете изучения, полученной на эмпирическом этапе исследования. На этой стадии «сырые» сведения группируются по тем или иным критериям, заносятся в сводные таблицы, а для наглядности представляются графически. Все эти манипуляции позволяют, во-первых, обнаружить и ликвидировать ошибки, совершенные при фиксации данных, и, во-вторых, выявить и изъять из общего массива нелепые данные, полученные в результате нарушения процедуры обследования, несоблюдения испытуемыми инструкции и т. п. Кроме того, первично обработанные данные, представая в удобной для обозрения форме, дают исследователю в первом приближении представление о характере всей совокупности данных в целом: об их однородности — неоднородности, компактности — разбросанности, четкости — размытости и т. д. Эта информация хорошо читается на наглядных формах представления данных и связана с понятиями «распределение данных».К основным методам первичной обработки относятся: табулирование,т. е. представление количественной информации в табличной форме, и построение диаграмм(рис. I), гистограмм (рис. 2), полигонов распределения (рис. 3)и кривых распределения(рис. 4). Диаграммы отражают распределение дискретных данных, остальные графические формы используются для представления распределения непрерывных данных.
19.Меры центральной тенденции. Меры центральной тенденции (measures of central tendency) — способы осмысления центральной или средней позиции множества наблюдений, оценок, группы чисел и т.д.На практике существуют большое разнообразие мер центральной тенденции (например, взвешенное, винсоризованное, гармоническое, геометрическое средние, среднее Колмогорова и др), но чаще всего встречаются:мода;среднее арифметическое;медиана.
20.Меры изменчивости признака. Меры изменчивости значений признака внутри группы оценивают разброс значений признака, вариативность.Размахом выборки называют разность между наибольшим и наименьшим значениями признака в выборке: . Размах измеряет на числовой шкале расстояние, в пределах которого изменяется варианта.Выборочная дисперсия является мерой разброса значений признака относительного среднего значения.Выборочная дисперсия – это среднее арифметическое квадратов отклонений значений
 от выборочной средней
 :
21.Алгоритм нахождения дисперсии. Алгоритм вычисления дисперсии
Для нахождения дисперсии D данных x1 ,х2, ..., хn измерения следует вычислить:
1) среднее значение 
2) отклонения данных от М, т. е. х1 - М, х2 - М, ..., хn-1 - М, хn - М;
3) квадраты (xi - M)2 отклонений (х1 - М) (i = 1, 2, 3, ..., n), найденных на предыдущем шаге;
4) среднее значение всех квадратов отклонений — это и есть дисперсия D:

 среднее квадратическое отклонение.
22.Ассиметрия и эксцесс. асимметрия и эксцесс – это числовые характеристики, выражающие количественную меру степени близости данного распределения к нормальному.Коэффициенты асимметрии и эксцесса теоретического распределенияПод теоретическим распределением понимается распределение вероятностей изучаемого признака Х генеральной совокупности, который трактуется как случайная величина Х. Для случайной величины Х введем безразмерные числовые характеристики:
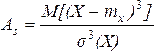 ,
 ,
которые называются соответственно коэффициентами асимметрии и эксцесса теоретического распределения. Они оценивают степень близости данного распределения к нормальному, а также характеризуют форму закона распределения вероятностей изучаемой случайной величины Х.
23.Закон нормального распределения. Норма́льное распределе́ние, также называемое распределением Гаусса или Гаусса — Лапласа — распределение вероятностей, которое в одномерном случае задаётся функцией плотности вероятности, совпадающей с функцией Гаусса: где параметр. — математическое ожидание (среднее значение), медиана и мода распределения, а параметр. — среднеквадратическое отклонение (. — дисперсия) распределения.
24.Проверка на нормальность распределения. Проверка нормальности распределения позволяет нам определиться с тем, какую статистику для окончательного анализа мы можем использовать: 1) если распределения сравниваемых признаков окажутся близки к нормальному, то мы можем использовать более мощную параметрическую статистику; 2) если распределение хотя бы одного из сравниваемых признаков окажется далеким от нормального, то при расчетах в дальнейшем нужно применять непараметрическую статистику.
25.Понятие статистической гипотезы. Под статистической гипотезой понимается высказывание относительно случайной величины, которое можно проверить по данной выборке, т.е. по результатам наблюдений. Процедуру сопоставления высказываний гипотезы с выборочными данными называют проверкой статистической гипотезы.Выделяют следующие основные виды высказываемых в ходе статистической обработки данных гипотез:1) О виде закона распределения случайной величины;2) Об однородности двух или нескольких обрабатываемых выработок или некоторых характеристик анализируемых совокупностей;3) О числовых значениях параметров исследуемой генеральной совокупности ;4) О виде зависимости между компонентами исследуемого многомерного признака.5) О независимости и стационарности обрабатываемого ряда наблюдений.Проверяемую статистическую гипотезу принято называть основной или нулевой гипотезой (H0:).Противоположную гипотезу называют альтернативной или конкурирующей(H1:)
26.Статистические критерии различий. Существует достаточно большое количество критериев различий. Каждый из них имеет свою специфику, различаясь между собой по основаниям (например, тип измерительной шкалы, максимальный объем выборки, количество выборок, качество выборки - зависимая и независимая).Кроме того, критерии различаются по мощности. Мощность критерия - это способность выявлять различия или отклонять нулевую гипотезу, если она не верна.Разнообразие критериев различий позволяет:выбирать критерий, адекватный типу шкалы, в которой получены экспериментальные данные;работать со связными (зависимыми) и несвязными (независимыми) выборками;работать с неравными по объему выборками;выбирать из критериев разные по мощности (в зависимости от целей исследования).Все критерии различий условно подразделены на две группы: параметрические и непараметрические критерии.Критерий различия называют параметрическим, если он основан на конкретном типе распределения генеральной совокупности (как правило, нормальном) или использует параметры этой совокупности (среднее, дисперсии и т. д.).Критерий различия называют непараметрическим, если он не базируется на предположении о типе распределения генеральной совокупности и не использует параметры этой совокупности. Поэтому для непараметрических критериев предлагается также использовать такой термин как ``критерий, свободный от распределения''.
27.Уровень статистической значимости. Уровень значимости - это вероятность того, что мы сочли различия существенными, а они на самом деле случайны.Когда мы указываем, что различия достоверны на 5%-ом уровне значимости, или при р0,05, то мы имеем виду, что вероятность того, что они все-таки недостоверны, составляет 0,05.Когда мы указываем, что различия достоверны на 1%-ом уровне значимости, или при р0,01, то мы имеем в виду, что вероятность того, что они все-таки недостоверны, составляет 0,01.Если перевести все это на более формализованный язык, то уровень значимости - это вероятность отклонения нулевой гипотезы, в то время как она верна.
28.Виды статистических гипотез. Статистическойназывается гипотеза (предположение) о генеральной совокупности, которая проверяется на основании выборочных данных.
Статистические гипотезы делятся на:
- гипотезы о виде предполагаемого распределения;
- гипотезы о предполагаемой величине параметра известного распределения.
Пример.
1. Генеральная совокупность распределена по закону Пуассона.
2. Дисперсии двух нормально распределённых генеральных совокупностей равны между собой.
Статистические гипотезы также разделяют на:
- нулевую (основную) H0, в качестве которой выступает выдвинутая гипотеза;
- конкурирующую (альтернативную) H1,в качестве которой выступает гипотеза, противоречащая H0.
Пример.
H0 состоит в предположении, что математическое ожидание a нормального распределения равно 10, тогда H1, в частности, может состоять в предположении  .
Классификация статистических гипотез выполняется и по количеству предположений в ней:
- гипотеза, содержащая одно предположение, называется простой;
- гипотеза, которая состоит из конечного или безконечного числа простых гипотез, называется сложной.
Пример:
1. Если распределение нормальное,  – известно, то гипотеза a=3 является простой.
2. Если распределение нормально, – неизвестно, то гипотеза a=3 является сложной.
Основная гипотеза H0 может быть правильной или неправильной. Т. к. вывод о правильности гипотезы H0 выполняется по результатам выборки, то всегда существует риск принять неправильное решение. Таким образом, в результате могут быть допущены ошибки двух родов:
- ошибка первого рода (риск производителя), состоящая в том, что будет отвергнута H0, когда она правильная;
- ошибка второго рода ( риск покупателя), состоящая в том, что будет принята H0, когда она неправильная.
Вероятность совершить ошибку первого рода принято называть уровнем значимости и обозначать  . Наиболее часто принимают равным 0,05 или 0,01.
Вероятность совершить ошибку второго рада обозначают через  , вероятность того, что не будет допущена ошибка второго рода равна
 и называется мощностью критерия.
29.Параметрические критерии и непараметрические критерии. От вида распределения и типа исследуемого признака зависит выбор подходящего математико-статистического критерия. Критерии делятся на два типа – параметрические и непараметрические.Параметрические критерии – критерии, основанные на оценке параметров распределения, к которым относятся среднее арифметическое, среднеквадратическое отклонение, дисперсия. Они применимы только в том случае, если численные данные подчиняются нормальному распределению. Если распределение отличается от нормального, то следует пользоваться так называемыми непараметрическими критериями.Непараметрические критерии не основаны на оценке параметров распределения и вообще не требуют, чтобы данные подчинялись какому-то определенному типу распределения. Непараметрические критерии дают более грубые оценки, чем параметрические, но являются более универсальными. А параметрические методы более точны, но лишь в случае, если правильно определено распределение совокупности.
30.Кривая нормального распределения К.Гаусса. Её свойства.Распределением называется закономерность встречаемости признака и разных его значений. Статистическое распределение может иметь графическое представление в виде полигона частот (ломаной линии, соединяющей точки; гистограммы; графика). Кривые распределения бывают одновершинные и многовершинные. Оценка типа распределения выступает в форме проверки нормальности эмпирического распределения. Форма распределения является некоторой обобщенной характеристикой выборки.Распределение частоты полученных результатов в виде графиков и гистограмм дает важную предварительную информацию о форме распределения признака, а именно о том, какие значения встречаются реже, какие чаще, насколько выражена изменчивость признака. Выделяют следующие типичные формы эмпирического распределения.Равномерное распределение — когда все значения встречаются с одинаковой частотой.Симметричное распределение — когда с одинаковой частотой встречаются крайние значения признака.Асимметричное распределение — может быть левосторонним (когда преобладает частота малых значений) или правосторонним (когда преобладает частота больших значений).Нормальное распределение — идеальный стандарт распределения, когда крайние значения встречаются редко и частота встречаемости постепенно повышается от крайних к серединным значениям признака.Нормальный закон распределения играет важнейшую роль в применении математико-статистических методов в психологии. Он лежит в основе измерений, разработки тестовых шкал, методов проверки гипотез.Нормальное распределение — вид распределения переменных, характеризуемый тем, что крайние значения признака в нем появляются достаточно редко, а значения, близкие к средней величине, — достаточно часто. Нормальным такое распределение называется потому, что оно очень часто встречалось в естественнонаучных исследованиях и казалось «нормой» всякого массового проявления признаков.



Вебинар для учителей

🎓 Свидетельство об участии ✨БЕСПЛАТНО!✨



